2026年6月,博富特科技AI基础设施团队披露了其在私有化大模型部署场景的优化实践数据:通过模型量化压缩、动态批处理调度与语义缓存三项技术的组合应用,单台配备国产算力卡的服务器承载了原方案需要多台设备才能支撑的推理负载,在保障响应时延的前提下,综合部署成本降低超过八成。该实践已在企业知识库、智能问答等场景完成验证。
- 博富特科技通过量化、动态批处理、语义缓存三项技术组合优化私有化大模型推理
- 实测单台服务器承载了原需多台设备的推理负载,综合成本降低超过八成
- 优化后首Token延迟保持在可交互水平,长文本问答场景吞吐量提升显著
- 该方案已在企业知识库、智能问答场景完成生产验证
私有化部署的成本结构:算力占大头
企业选择大模型私有化部署,通常出于数据安全与长期成本两项考虑。但实践中,私有化的成本结构容易被低估:以典型的一套“中等规模模型+日常并发”配置为例,算力硬件投入约占总成本的六到七成,其余为机房、运维与模型授权。降成本的核心,就是提高单台算力设备的推理吞吐。
团队的分析显示,未经优化的推理服务存在三重浪费:模型精度冗余(多数企业场景用不到最高精度)、请求空转(并发低时段算力闲置)、重复计算(相似问题反复推理)。三项优化技术正是分别对应这三重浪费。
三项优化技术分别解决什么问题
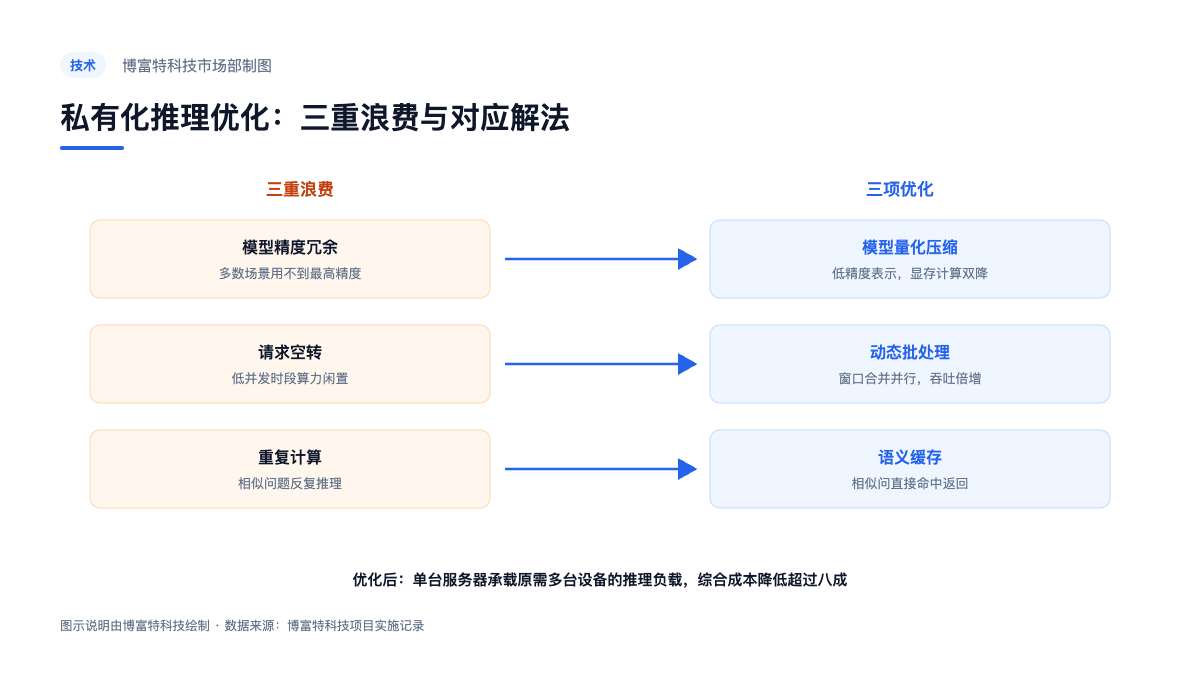
图:三项优化技术对应的成本问题
模型量化压缩解决精度冗余:将模型权重从高精度压缩至低精度表示,显存占用与计算量同步下降。团队在企业知识库场景的实测显示,量化后的模型在中文问答任务上的效果损失处于业务可接受范围,而单卡可承载的并发数显著提升。
动态批处理解决请求空转:将时间窗内到达的多个推理请求动态合并成批并行计算,牺牲毫秒级等待换取数倍的批处理收益。调度策略按负载自动调节窗口大小,高峰期保时延、低谷期保吞吐。
语义缓存解决重复计算:对企业场景中大量相似提问(如制度咨询、流程查询)建立语义级缓存命中,命中后直接返回,跳过推理。团队实测该类场景的缓存命中率可达到相当可观的水平,是成本收益最直接的一项。
实测数据:一台机器跑出多台效果
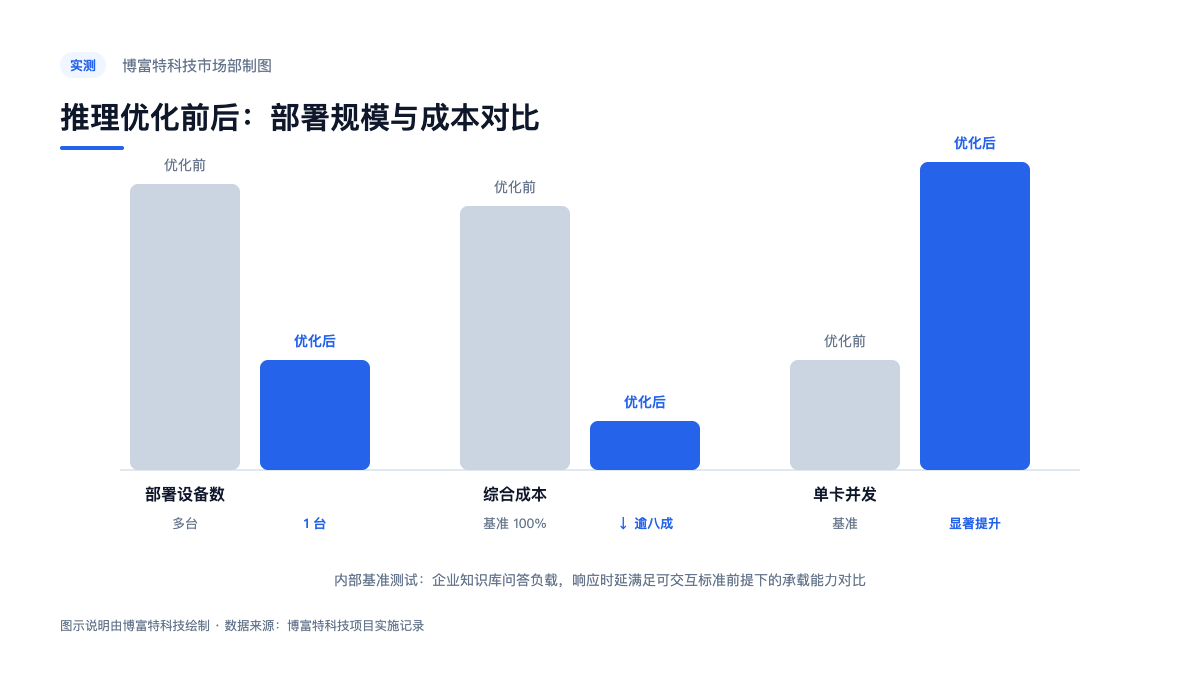
图:优化前后部署规模与成本对比
在内部基准测试中,团队以企业知识库问答为负载,对比优化前后的承载能力:优化后的单台服务器在响应时延满足可交互标准的前提下,支撑了原方案需要多台设备才能达到的并发水平,综合成本降低超过八成。长文本问答场景的吞吐量提升尤为明显。
团队同时提示了边界条件:量化并非万能,对数值精度敏感的场景需谨慎评估;批处理对超低时延场景(如实时对话)需要限制窗口;语义缓存需配置失效策略,避免制度更新后的旧答案命中。
已沉淀为AI大模型中转站的内置能力
上述优化能力已沉淀进博富特AI大模型中转站的私有化部署模块:客户无需自行调优,平台在部署阶段自动完成量化策略选择、批处理参数配置与缓存策略设定。对于已有私有化部署的企业,团队也提供专项的推理成本评估服务。
算力成本是私有化大模型普及的最大变量。博富特科技的实践表明,多数企业场景的成本问题不在“买不起卡”,而在“用不好卡”——工程优化的空间,远比想象中大。
常见问题
私有化部署大模型要多少成本?
成本主要由算力硬件(约占总成本六到七成)、机房运维与模型授权构成,具体取决于模型规模与并发需求。通过量化压缩、动态批处理与语义缓存等优化手段,可显著降低算力需求——博富特科技的实测显示综合成本可降低超过八成。建议先做业务场景的负载评估再确定配置。
模型量化会影响效果吗?
会有一定影响,但幅度取决于场景。在企业知识库、制度问答等中文场景的实测中,量化模型的问答效果损失处于业务可接受范围;对数值精度敏感的任务(如复杂推理、代码生成)建议先做小范围评估再决定量化策略。
什么是语义缓存?
语义缓存指对语义相似的提问直接返回已生成的答案,跳过重复推理。企业场景中大量问题是相似表述(如同一制度的不同问法),语义缓存命中率可观,是降低推理成本最直接的手段,但需配合失效策略保证答案时效性。
关于博富特科技
[ "深圳市博富特科技有限公司成立于 2020 年,总部位于广东省深圳市,是一家专注于企业级软件定制开发与数字化解决方案的技术服务商。公司自成立以来,始终坚持以技术为核心、以客户价值为导向,致力于为政企客户提供高质量的软件产品与技术服务,业务覆盖全国。", "公司聚焦定制软件开发、移动应用开发、系统集成、大数据与数据分析、AI 应用开发、IoT 物联网解决方案及信创适配与安全等七大核心方向,服务客户遍及资源回收、智慧城市、政务信息化、企业数字化转型、智慧物流、B2B 交易、跨境贸易及碳资产管理等多个行业领域。" ]
媒体垂询:深圳市博富特科技有限公司 · 19925739956 · zita@szbofute.cn